Le défi
Les équipes d’une entreprise dont l’activité repose sur ses données rapprochent des objets entre eux pour fonder leurs analyses. Sans base commune, chaque recherche repart des sources, une à une, chacune avec son format et son vocabulaire.
La question à trancher : quel modèle commun imposer à des millions d’enregistrements hétérogènes pour que les équipes interrogent une seule base, sans connaître la structure de chaque source ? Un objet, ici, est une fiche unique et ses attributs, quelle que soit la source qui l’a fournie.
Le volume n’était pas la première difficulté. La cohérence l’était : rapprocher un même objet décrit par deux sources, et donner à un champ le même sens d’une source à l’autre.
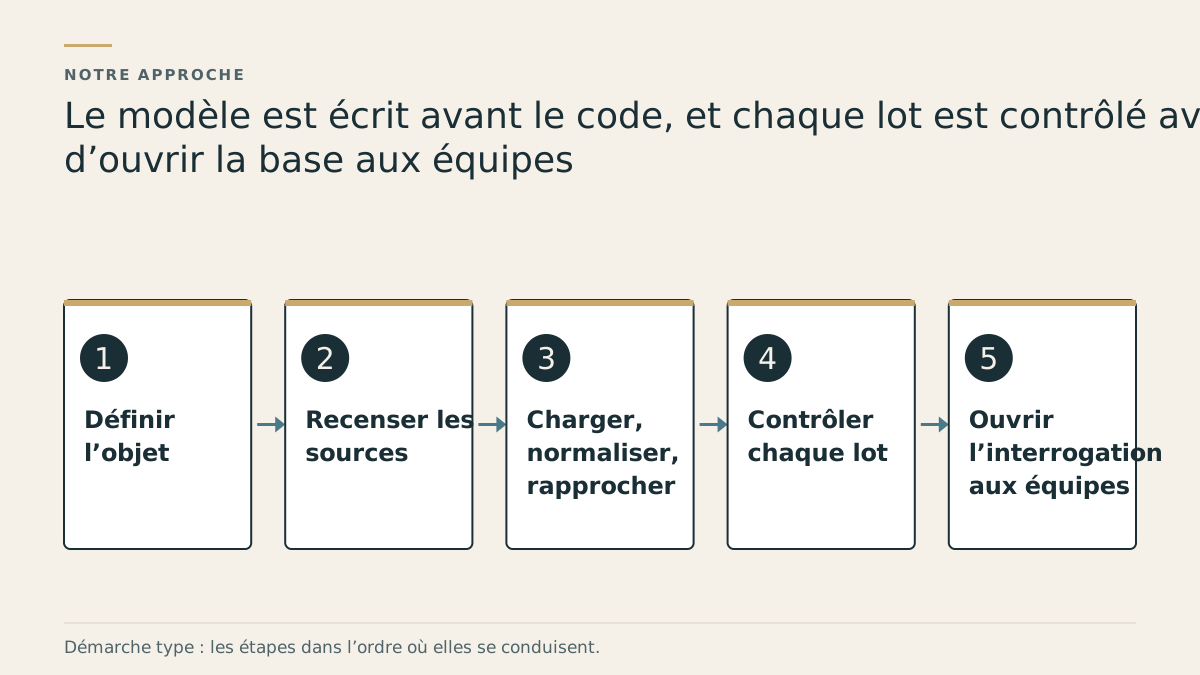
Notre approche
Définir l’objet
Avant le code, le modèle est écrit : ce qu’est un objet, ses champs obligatoires, le sens de chacun. Hypothèse écrite : les équipes interrogent la base par un petit nombre de critères stables, que le modèle rend fiables en priorité.
Recenser les sources
Pour chaque source : format, champs disponibles, qualité, conditions d’usage, rythme de mise à jour. La table de correspondance entre chaque champ source et le modèle commun devient la référence du chantier.
Charger, normaliser, rapprocher
Chargement par lots, avec une copie brute de chaque lot conservée, puis mise au même format des dates, des unités et des noms. Le rapprochement des doublons suit des règles écrites : des clés de blocage limitent les comparaisons, un score de similarité décide au-dessus d’un seuil, une règle de survivance fixe, champ par champ, la source qui l’emporte. Hypothèse écrite : un rapprochement douteux reste séparé, car deux objets fusionnés à tort coûtent plus cher qu’un doublon visible.
Contrôler chaque lot
Chaque lot passe des contrôles automatiques sur la totalité des objets : comptes réconciliés entre sources et base, champs obligatoires remplis, identifiants uniques. Un échantillon tiré au hasard mesure en plus la justesse du rapprochement, contre un taux d’écart accepté fixé par écrit à l’avance. Une règle qui dépasse ce seuil est corrigée et le lot rechargé : on ne corrige pas les objets un par un à la main.
Ouvrir l’interrogation aux équipes
Les équipes interrogent la base par critères, avec des requêtes types et la documentation du modèle. Les sources sont ensuite rechargées à leur rythme, sans changer les identifiants déjà attribués.
L’impact
25 millions d’objets structurés selon un même modèle, interrogeables par les équipes de l’entreprise. Ce qui a été livré : la base et son modèle de données documenté.
Livrables types
- Base de données consolidée, chargée par lots contrôlés
- Modèle de données documenté (objet, champs, sens de chaque champ)
- Table de correspondance entre les sources et le modèle commun
- Règles écrites de normalisation, de rapprochement et de survivance
- Rapport de contrôle par lot : comptes, complétude, justesse du rapprochement
- Requêtes types et documentation pour les équipes
Ce que ce cas ne dit pas. Le cas établit un volume structuré et un accès des équipes, pas un gain de temps ni de revenu mesuré.